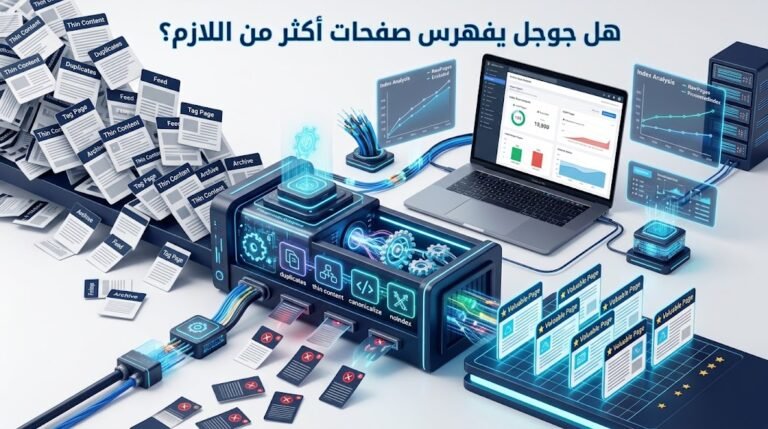
اكتشاف مصائد الزحف يعني العثور على أنماط URLs التي تسمح للزاحف بالدخول في مساحة ضخمة أو شبه لا نهائية من الصفحات منخفضة القيمة، مثل التقويمات والفلاتر المتراكبة وSession IDs وصفحات البحث الداخلي والمعلمات التي يمكن تركيبها بطرق كثيرة. المشكلة ليست أن الموقع كبير، بل أن الزاحف يستطيع استهلاك وقت هائل داخل مسارات لا تضيف قيمة للفهرسة.
أفضل طريقة لـاكتشاف مصائد الزحف هي مراقبة نمو عدد URLs أثناء Crawl ومقارنته بالسجلات والمعلمات وأنماط الروابط. إذا كان عدد الصفحات المكتشفة يزيد بصورة غير منطقية كلما تقدم الزحف، فغالبًا توجد قاعدة توليد تحتاج فحصًا.
ما الفرق بين موقع كبير ومصيدة زحف
متجر يحتوي مليون منتج حقيقي ليس Crawl Trap لمجرد حجمه. المصيدة تظهر عندما يولد النظام عددًا ضخمًا من النسخ أو التركيبات بدون نية أو محتوى مستقل.
| الحالة | هل هي مصيدة محتملة |
| مليون منتج حقيقي | لا بمجرد العدد |
| فلتر لون × مقاس × ترتيب × سعر بلا حدود | نعم غالبًا |
| تقويم يستطيع توليد سنوات مستقبلية بلا نهاية | نعم |
| Session ID جديد في كل رابط | نعم |
| Landing Pages بفلاتر عليها طلب حقيقي | ليست بالضرورة |
راقب نمو Crawl
ابدأ Crawl محدودًا وراقب عدد URLs الجديدة حسب العمق. إذا استمر العدد في التضخم بسبب Pattern واحد، أوقف الزحف وافحصه بدل انتظار ملايين الصفحات.
هذه من أسرع طرق اكتشاف مصائد الزحف قبل استهلاك وقت وموارد الأداة.
اجمع URLs حسب Pattern
قسّم الروابط حسب Folder أو Parameter أو Regex. ستظهر الأنماط التي تولد أكبر حجم من الصفحات بوضوح.
- ?sort=
- ?page=
- ?filter=
- ?session=
- تقويمات بالتاريخ.
- بحث داخلي.
- مسارات Tags أو Facets متعددة.
استخدم Log Files لمعرفة ما يزحفه Googlebot فعلًا
Crawler يكشف ما يمكن الوصول إليه، بينما Logs تكشف أين يذهب Googlebot في الواقع. إذا كانت أغلب الطلبات تذهب إلى Parameters منخفضة القيمة، فالمشكلة لم تعد نظرية.
في اكتشاف مصائد الزحف الجمع بين Crawl وLogs يحدد الحجم الممكن والحجم الفعلي للهدر.
التقويمات ومسارات التاريخ
بعض الأنظمة تولد روابط للشهر السابق والتالي بلا نهاية، فيستطيع الزاحف الانتقال إلى سنوات بعيدة لا تحتوي محتوى.
حدد حدودًا حقيقية للتنقل ولا تولد روابط إلى فترات بلا محتوى.
الفلاتر متعددة التركيبات
كل Facet منفرد قد يكون مفيدًا، لكن تركيب خمسة فلاتر معًا يمكن أن ينتج ملايين URLs.
حدد أي Filters تستحق Links قابلة للزحف وأيها يجب أن تبقى وظائف واجهة بدون إنشاء مساحة URL دائمة.
Session IDs
إذا أضاف الموقع معرف جلسة مختلفًا لكل مستخدم أو طلب داخل URL، يصبح نفس المحتوى متاحًا بعناوين شبه غير محدودة. الأفضل الاحتفاظ بحالة الجلسة خارج URL العام عندما يكون ذلك ممكنًا.
البحث الداخلي
روابط نتائج البحث التي يمكن توليدها لأي كلمة قد تفتح عددًا ضخمًا من الصفحات الضعيفة. لا تجعل كل Search Query رابطًا قابلاً للزحف والفهرسة.
ترتيب وفرز المنتجات
Parameters مثل الأرخص والأحدث قد تغير ترتيب نفس القائمة فقط. إذا كان كل ترتيب URL مستقلًا ومربوطًا داخليًا، فقد يضاعف حجم الزحف بدون قيمة مستقلة.
لا تستخدم robots.txt كحل أعمى
حظر Pattern في robots قد يقلل الزحف، لكنه لا يعالج مصدر الروابط ولا يسمح للبوت بقراءة Canonical أو noindex داخل الصفحة المحظورة.
جزء من اكتشاف مصائد الزحف هو اختيار العلاج بعد فهم سبب التوليد، لا إغلاق كل شيء من robots مباشرة.
أوقف توليد الروابط عندما يكون ذلك ممكنًا
إذا كان URL لا يجب أن يكتشف أصلًا، فأفضل حل غالبًا هو عدم إنشاء روابط قابلة للزحف إليه من البداية.
هذا أقوى من معالجة ملايين النسخ بعد أن تصبح جزءًا من بنية الموقع.
Canonical للحالات المتشابهة
Canonical مفيد عندما تحتاج النسخ أن تبقى للمستخدم لكن تريد توضيح النسخة الأساسية، لكنه لا يمنع Googlebot من اكتشاف كل URL إذا كانت الروابط ما زالت تولدها.
Noindex للحالات الوظيفية
يمكن استخدام noindex لصفحات تحتاج أن تبقى متاحة للمستخدم ولا تستحق البحث، لكن راقب استمرار الزحف إليها إذا كان الحجم ضخمًا.
متى يكون Facet ذا قيمة
لا تغلق كل Filters. بعض التركيبات تمثل طلبًا طويل الذيل حقيقيًا وتستحق Landing Page مستقرة ومحتوى وعنوانًا وروابط داخلية.
الفرق بين فرصة SEO ومصيدة هو وجود نية مستقلة وقيمة فعلية للمستخدم.
إشارات تدل على وجود مصيدة
- عدد URLs المكتشفة ينمو بلا نهاية أثناء Crawl.
- Parameters محددة تمثل نسبة كبيرة من السجلات.
- عمق الزحف يستمر دون الوصول إلى نهاية منطقية.
- Search Console تعرض أعدادًا ضخمة من صفحات مكررة أو غير مفهرسة.
- Googlebot يزور صفحات Filters أكثر من الصفحات التجارية المهمة.
خطة احتواء عملية
- حدد Pattern المسبب.
- قِس حجمه في Crawl وLogs.
- حدد هل توجد نية بحث حقيقية.
- أوقف توليد الروابط منخفضة القيمة عندما يمكن.
- استخدم Canonical أو noindex أو robots حسب وظيفة المسار.
- نظف Sitemap من النسخ غير المهمة.
- أعد Crawl وراجع Logs بعد التنفيذ.
أخطاء شائعة
- اعتبار كل موقع كبير مصيدة زحف.
- السماح بكل تركيبات الفلاتر.
- استخدام robots قبل فهم النمط.
- الاعتماد على Canonical مع بقاء ملايين الروابط.
- منع Filters لها طلب بحث فعلي.
- عدم مراقبة Logs بعد الإصلاح.
أوقف انفجار URLs عند المصدر
اكتشاف مصائد الزحف ينجح عندما تعرف أي قاعدة أو مكون يولد مساحة URLs غير منطقية، ثم توقف أو تتحكم في المصدر قبل أن يستهلك الزاحف وقته داخل صفحات منخفضة القيمة. استخدم Crawl وLogs معًا، وافصل بين المخزون الحقيقي والنسخ اللانهائية.
ولفهم Crawl Traps ضمن بقية عناصر الزحف والفهرسة يمكن الرجوع إلى السيو التقني. وإذا كان الموقع كبيرًا ويحتاج تحليلًا لملايين URLs يمكن الانتقال إلى خدمات سيو.